Como a IA constrói uma base de conhecimento sólida: RAG, embeddings e modelos de linguagem na prática
RAG, embeddings e modelos de linguagem: como a IA transforma manuais, políticas e históricos em uma base de conhecimento sólida que responde com fonte.
A nova analista de atendimento precisou responder, no terceiro dia de trabalho, como funcionava a política de reembolso da empresa. A resposta oficial existe — são 14 páginas de manual aprovado pela diretoria. Só que o manual está numa pasta compartilhada que quase ninguém sabe que existe, o caso parecido mais recente foi resolvido por uma analista que pediu demissão em janeiro, e a orientação que circula no grupo do time contradiz a norma. A analista respondeu com base no grupo. A empresa pagou um reembolso que a política não previa.
Isso não é descuido. É o custo do conhecimento que vive solto: na cabeça das pessoas, em arquivos espalhados, em versões que se contradizem. Toda empresa tem esse problema — e é exatamente ele que uma base de conhecimento bem construída resolve. Este artigo explica, sem jargão, como três peças de inteligência artificial — modelos de linguagem, embeddings e a técnica conhecida como RAG — se combinam para transformar manuais, políticas e históricos em uma base que responde, aponta a fonte e não depende da memória de quem saiu.
O problema: o conhecimento da empresa não mora em lugar nenhum
Antes de falar de tecnologia, vale nomear o problema que ela resolve. Toda empresa tem conhecimento que só existe na prática: o procedimento que a analista sênior aprendeu na unha, a exceção que o supervisor autorizou no mês passado, a resposta que o suporte deu trinta vezes e nunca registrou. Quando esse conhecimento está só na memória, três coisas acontecem:
- Ele se perde. Quem sabia pede demissão, entra de férias ou é promovido — e o “como se faz” vai junto.
- Ele se contradiz. O manual diz uma coisa, o WhatsApp diz outra, e quem atende escolhe a versão que parece mais fácil.
- Ele não escala. Cada pessoa nova aprende do zero, cada pergunta é respondida de um jeito, e o padrão depende de herói, não de processo.
A base de conhecimento tradicional tentava resolver isso com pastas e documentos. Ela falha por um motivo simples: o conhecimento só é útil se for encontrado no momento em que é preciso — e procurar em centenas de documentos, na hora em que o cliente espera resposta, é exatamente o que ninguém faz.
É aí que entram as três peças.
A primeira peça: o modelo de linguagem, quem conversa
O modelo de linguagem — o tal LLM, de large language model — é a peça que todo mundo já conheceu: é ele que conversa, resume, escreve e responde em linguagem natural. Ele foi treinado com uma quantidade imensa de texto público e aprendeu padrões de linguagem: como frases se organizam, como uma explicação costuma terminar, como responder a um pedido bem formulado.
O ponto que quase todo mundo erra é entender o que ele faz e o que ele não faz. O modelo não é um banco de dados da sua empresa. Ele não “sabe” a sua política de reembolso, o seu procedimento interno ou o histórico dos seus clientes — porque nada disso esteve no treinamento dele. Quando perguntado sobre algo que ele não conhece, ele não responde “não sei”: ele inventa a resposta mais plausível, com a mesma segurança com que acerta. É o fenômeno conhecido como alucinação, e ele é o motivo pelo qual perguntar direto a um modelo de linguagem sobre a sua operação é perigoso.
A boa notícia é que o modelo não precisa saber a resposta. Ele precisa apenas ser capaz de usá-la quando ela for entregue a ele — e é isso que as outras duas peças fazem.
“O modelo de linguagem não é a memória da empresa. É a boca: sabe falar bem, mas precisa que alguém entregue a informação certa antes de abrir a boca.”
A segunda peça: o embedding, quem entende o significado
A segunda peça resolve um problema silencioso: a busca por palavra-chave. Se um funcionário pergunta “como faço para devolver um produto com defeito?”, um sistema tradicional procura os documentos que contêm as palavras “devolver”, “produto” e “defeito”. Se o manual diz “troca de mercadoria em desacordo com o pedido”, a busca não encontra nada — porque as palavras são diferentes, embora o significado seja o mesmo.
O embedding transforma texto em uma lista de números — um vetor — que funciona como uma impressão digital do significado. Textos com sentido parecido geram vetores parecidos, mesmo quando usam palavras diferentes. “Como devolver um produto com defeito” e “troca de mercadoria em desacordo com o pedido” ficam perto nesse espaço, porque significam quase a mesma coisa.
É isso que permite a busca semântica: em vez de procurar a palavra exata, o sistema procura o trecho com o sentido mais próximo da pergunta. Em uma base com milhares de documentos, esses vetores ficam guardados em um índice próprio — um banco de dados vetorial — que consegue achar, em frações de segundo, os poucos trechos mais relevantes entre milhares.
A terceira peça: RAG, a receita que junta tudo
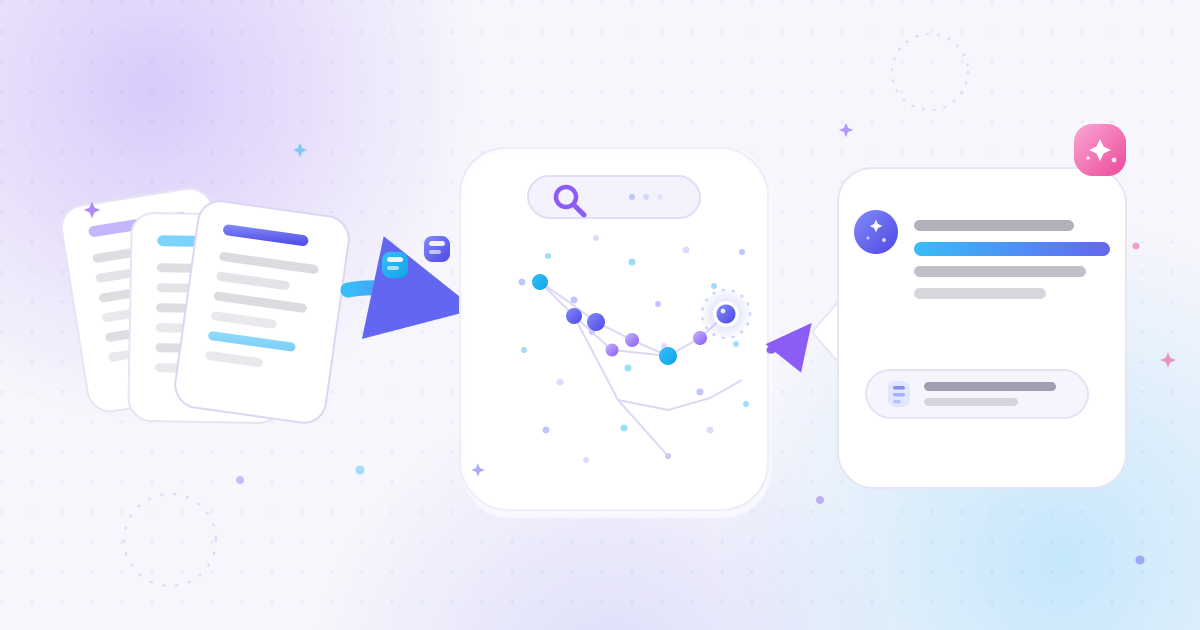
RAG vem do inglês Retrieval-Augmented Generation — geração aumentada por recuperação. Por trás do nome existe uma ideia simples: em vez de o modelo responder de memória, o sistema busca nos seus documentos, a cada pergunta, o conteúdo que pode responder, e entrega esse conteúdo ao modelo como contexto.
O passo a passo, sem a camada técnica:
- Os documentos da empresa são preparados. Manuais, políticas, procedimentos e FAQs são separados em trechos pequenos — pedaços de texto com tamanho suficiente para carregar uma ideia completa — e cada trecho ganha um rótulo com a origem: qual documento, qual versão, de que área.
- Cada trecho vira um embedding. O significado de cada pedaço é convertido em vetor e guardado no índice vetorial. A partir daí, a base pode ser consultada por sentido.
- A pergunta chega. Um funcionário (ou um sistema de atendimento) pergunta em linguagem natural. A pergunta também é convertida em embedding.
- O sistema busca os trechos mais próximos. Ele compara o vetor da pergunta com os vetores de todos os trechos e seleciona os mais relevantes — como quem puxa da estante os três parágrafos que realmente respondem.
- Os trechos viram contexto para o modelo. A pergunta e os trechos encontrados são enviados juntos ao modelo de linguagem, com uma instrução: responda com base apenas no que foi entregue e indique a fonte.
- O modelo responde ancorado. A resposta nasce do documento real, e não da memória do modelo. Se o documento não contém a resposta, o sistema é orientado a dizer que não encontrou — em vez de inventar.
É assim que uma base de conhecimento “sólida” funciona na prática: o conhecimento continua nos documentos que a empresa controla, mas passa a ser encontrável por qualquer pessoa, em linguagem natural, com a fonte à vista.
“RAG não é um modelo novo. É um método: em vez de o modelo responder de memória, ele consulta os seus documentos a cada pergunta — e responde apontando a origem.”
Por que não basta “treinar” o modelo com os documentos?
A pergunta mais comum de quem ouve falar de RAG é: por que não pegar os documentos e “ensinar” o modelo de uma vez? A técnica existe — chama-se ajuste fino, ou fine-tuning — mas ela serve para outro propósito.
O ajuste fino ensina o modelo a se comportar de um jeito: a usar um tom, a seguir um formato, a executar um tipo de tarefa. Ele não é uma forma confiável de gravar fatos que mudam — e uma política de reembolso muda, um procedimento é revisado, um produto sai de linha. Cada alteração no ajuste fino exige um novo ciclo caro e demorado de treinamento. Já no RAG, o conhecimento vive nos documentos: quando a política muda, o documento é atualizado — e a próxima resposta já usa a versão nova, sem retreinar nada.
Na prática, as duas técnicas se complementam: o ajuste fino dá o comportamento, o RAG dá o conteúdo. Para uma base de conhecimento que precisa estar atualizada e apontar a fonte, o RAG é quase sempre a peça certa.
Onde isso muda o dia a dia
Os benefícios aparecem onde o conhecimento é consultado com frequência e o custo do erro é alto:
- Atendimento e suporte. O time responde com base na política vigente, não na versão do grupo de WhatsApp — e o cliente recebe a resposta certa na primeira vez.
- Onboarding. A pessoa nova deixa de depender de “pergunta pra fulana” e passa a consultar uma base que responde, com o manual certo indicado.
- Áreas reguladas e auditoria. Quando uma resposta precisa estar ancorada na norma, ter a fonte citada vira requisito de conformidade — e cada resposta deixa rastro do documento que a sustentou.
- Retenção de conhecimento. O procedimento que vivia na cabeça de quem saiu vira documento, e o documento vira resposta disponível para todos.
A tabela resume a diferença entre a pasta de documentos e a base com RAG:
| Dimensão | Documentos parados | Base de conhecimento com RAG |
|---|---|---|
| Busca | Só acha se você souber a palavra exata | Encontra pelo significado, do jeito que você pergunta |
| Idioma | Entrega o documento cru | Responde em linguagem natural, resume e compara |
| Atualização | Manual, esquecida, com versões contraditórias | Documento novo entra e a resposta passa a usá-lo |
| Fonte | Você mesmo precisa achar o trecho | A resposta indica o trecho de origem |
| Conhecimento de quem saiu | Perde-se com a pessoa | Vira documento e permanece na base |
Limites e cuidados
Ser honesto sobre o que essa tecnologia não faz é parte de construir uma base realmente sólida:
- A alucinação reduz, não desaparece. Se a resposta não está nos documentos, o modelo ainda pode tentar adivinhar. Por isso a instrução de “diga que não encontrou” e a revisão humana em decisões importantes são parte do desenho, não um detalhe.
- A base é tão boa quanto os documentos. Política desatualizada, manual contraditório e procedimento desenhado no chute entram na resposta com a mesma autoridade dos documentos corretos. Não existe RAG que conserte uma base bagunçada — arrumar os documentos é pré-requisito.
- Documento ruim quebra a busca. PDF escaneado sem texto, planilha sem cabeçalho e anotação solta não viram embedding aproveitável. Documentos precisam ser legíveis e estruturados antes de entrar na base.
- Acesso e LGPD precisam ser desenhados. Se a base contém dado pessoal ou informação confidencial, nem todo funcionário — e nenhum visitante — pode receber qualquer resposta. Controle de acesso, contrato com o fornecedor e clareza sobre onde os dados são processados são inegociáveis.
- Precisa de um dono. Alguém precisa manter a base atualizada, revisar as respostas que o sistema não soube dar e decidir o que entra e o que sai. Base sem curadoria envelhece — e base envelhecida é pior que nenhuma, porque responde errado com autoridade.
- Não substitui o julgamento humano. A base acelera e padroniza a consulta; a decisão sobre exceções, valores e riscos continua sendo de quem responde por elas.
Por onde começar
Como em toda aplicação de IA, a ordem certa é: arrumar o conhecimento primeiro, tecnologia depois.
- Escolha um recorte pequeno. Uma área e um conjunto finito de documentos — uma política, um manual, um FAQ — valem mais do que tentar digitalizar a empresa inteira de uma vez.
- Arrume os documentos. Versão única e vigente, data, autor e área de cada um. Se dois documentos se contradizem, resolva a contradição antes de colocá-los na base.
- Defina as perguntas que importam. Levante as vinte ou trinta perguntas reais que o time mais recebe — são elas que vão testar se a base responde bem.
- Teste resposta e fonte. Para cada pergunta, confira se o trecho recuperado é o certo e se a resposta gerada está ancorada nele. Onde errar, ajuste os documentos ou a divisão em trechos.
- Crie o fluxo de atualização. Quem revisa a base, com que frequência, e como um documento novo entra — com o mesmo cuidado que uma política oficial merece.
- Meça antes de expandir. Tempo para achar uma resposta, consultas resolvidas sem escalar para um humano, consistência entre atendentes e acerto das respostas com fonte. Com esses números, decida a próxima área.
O objetivo não é construir o sistema mais sofisticado. É construir a base em que a empresa confia — e confiança nasce de respostas certas, com fonte, repetidas vezes.
Conclusão
Uma base de conhecimento sólida nunca foi um problema de tecnologia. Foi sempre um problema de organização: conhecimento que não está documentado se perde, e conhecimento documentado mas inacessível não ajuda ninguém. A inteligência artificial — com os modelos de linguagem para conversar, os embeddings para buscar por significado e o RAG para ancorar cada resposta na fonte — resolve a segunda metade do problema: fazer o conhecimento certo chegar à pessoa certa, no momento em que ela precisa, em linguagem natural e com a origem à vista.
A primeira metade continua sendo sua: documentos organizados, atualizados e com um dono. Quando as duas metades se encontram, a empresa deixa de pagar o preço do conhecimento que mora na cabeça de quem saiu — e passa a responder com a solidez de quem sabe onde está o que sabe.
Quer transformar manuais, políticas e históricos da sua empresa em uma base de conhecimento que responde com fonte? A INFOINSIGHT ajuda a mapear o conhecimento que já existe, organizar os documentos e desenhar a primeira aplicação com critérios de qualidade, segurança e LGPD.
Sobre a INFOINSIGHT
A INFOINSIGHT é uma empresa brasileira de Inteligência Artificial para Negócios. Ajudamos empresas e profissionais a transformar dados em decisões, com foco em resultados práticos e mensuráveis. Este conteúdo faz parte do INSIGHTS by INFO, o blog da INFOINSIGHT.
Comentários